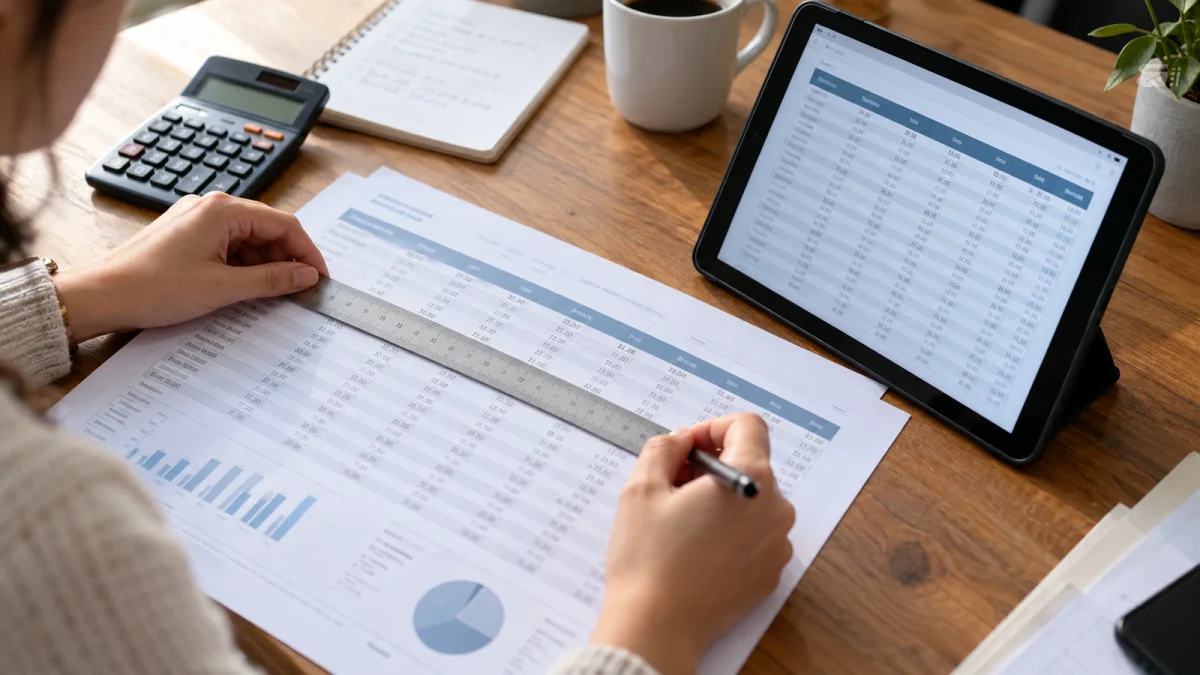
Vous demandez à une IA de transformer un tableau de PDF en fichier exploitable. La réponse paraît propre et les colonnes sont bien alignées. Pourtant, une ligne a pu être omise, un montant affecté au mauvais intitulé ou une note intégrée dans les chiffres. La présentation ne permet pas de conclure à la fidélité de l’extraction. Il faut comparer la structure et les valeurs au document source, avec une méthode adaptée au risque.
En bref : contrôlez les en-têtes, les unités et un échantillon de cellules. Un total correct ne suffit pas si des valeurs ont été déplacées ou compensent plusieurs erreurs.
Identifier ce que contient réellement le PDF
Un document peut contenir du texte sélectionnable, des pages scannées ou un mélange des deux. La qualité de l’extraction dépend notamment de cette structure, du contraste et de la mise en page. Repérez les cellules fusionnées, les colonnes sur plusieurs pages et les lignes dont l’intitulé est long. Ces particularités doivent figurer dans votre plan de contrôle.
Demandez une sortie qui préserve l’ordre des lignes et les intitulés. Précisez que les valeurs illisibles doivent être signalées, sans être complétées par une supposition. Pour un document sensible, utilisez uniquement un environnement autorisé par votre organisation. Une bonne extraction ne justifie pas l’envoi d’un fichier à un service dont vous n’avez pas examiné les conditions d’utilisation des données.
Contrôler les conventions numériques
Un espace peut séparer les milliers et une virgule peut représenter une décimale. Un tiret peut signifier zéro, donnée absente ou valeur non applicable selon la légende. Vérifiez également les pourcentages, les montants négatifs et les unités affichées dans l’en-tête. Un tableau exprimé en milliers d’euros ne doit pas être réutilisé comme s’il contenait des euros.
Préservez d’abord la représentation originale dans une colonne de référence lorsque votre processus le permet. Effectuez les conversions dans une étape distincte et documentée. Cette séparation aide à comprendre d’où vient une différence. Elle évite de mélanger une erreur de reconnaissance avec un choix volontaire de normalisation destiné au tableur ou au logiciel de destination.
Comparer la structure avant les calculs
Comptez les lignes et les colonnes, puis examinez les premières et dernières entrées de chaque page. Les changements de page sont des endroits fréquents de confusion : répétition d’en-tête, note de bas de page ou ligne coupée. Vérifiez que chaque valeur garde son intitulé et sa période. Deux cellules interverties peuvent laisser le total inchangé.
Choisissez des contrôles ciblés en plus d’un échantillon réparti. Incluez une ligne comportant une valeur nulle, une décimale, un signe négatif et une cellule vide si elles existent. Pour un usage critique, une vérification exhaustive peut être nécessaire. Le niveau de contrôle doit suivre les conséquences d’une erreur, plutôt que le caractère impressionnant de la démonstration.
Garder la source et le journal de correction
Enregistrez le document source, la sortie initiale et la version corrigée. Notez les erreurs relevées et les transformations effectuées. Si plusieurs personnes travaillent sur l’extraction, définissez qui valide le fichier final. Une sortie corrigée mais sans trace peut être difficile à défendre lorsque le tableau est réutilisé dans une présentation ou un calcul ultérieur.
Commencez avec quelques pages et mesurez le temps de vérification. Si les erreurs se concentrent sur une structure précise, adaptez la consigne ou utilisez une méthode d’extraction plus appropriée. L’IA peut accélérer la préparation, mais l’intérêt du processus se juge sur un résultat vérifié. Une automatisation utile réduit le travail total sans rendre invisibles les endroits où une décision humaine reste nécessaire.